Umwandeln & Export
Nicht jedes PDF ist gleich brauchbar: Ein Scan lässt sich nicht durchsuchen, und manchmal brauchst du den Inhalt in Word, als Bilder oder als reinen Text. Umgekehrt willst du Fotos oder Office-Dateien als PDF haben. Dieses Kapitel erklärt die Texterkennung und alle Wege hinein ins PDF und wieder heraus.
Alle Befehle findest du im Menü (Mehr) rechts in der Werkzeugleiste: die Texterkennung und die Exporte von Seiten und Text in der linken Spalte, die Umwandlungen in der rechten Spalte unter .
| Befehl | Ergebnis |
|---|---|
| Unsichtbare Textebene auf gescannten Seiten – das Dokument wird durchsuchbar. | |
| Aktuelle Seite als PNG mit 300 dpi. | |
| Text aller Seiten als UTF-8-Textdatei (.txt). | |
| Text mit Absätzen und Überschriften als Word-Datei. | |
| Jede Seite als PNG mit 150 dpi in einen Ordner. | |
| Neue PDF aus PNG- und JPEG-Bildern. | |
| Word-, Excel-, PowerPoint- und OpenDocument-Dateien als PDF (braucht LibreOffice). |
Texterkennung (OCR)
Ein gescanntes Dokument besteht aus Bildern – du kannst darin nicht suchen, keinen Text markieren, und der KI-Assistent sieht nur leere Seiten. Öffnest du so ein PDF, weist Pagelier dich darauf hin: „Dieses PDF enthält keinen Text (Scan). Menü „…“, „Text erkennen (OCR)“ macht es durchsuchbar.“
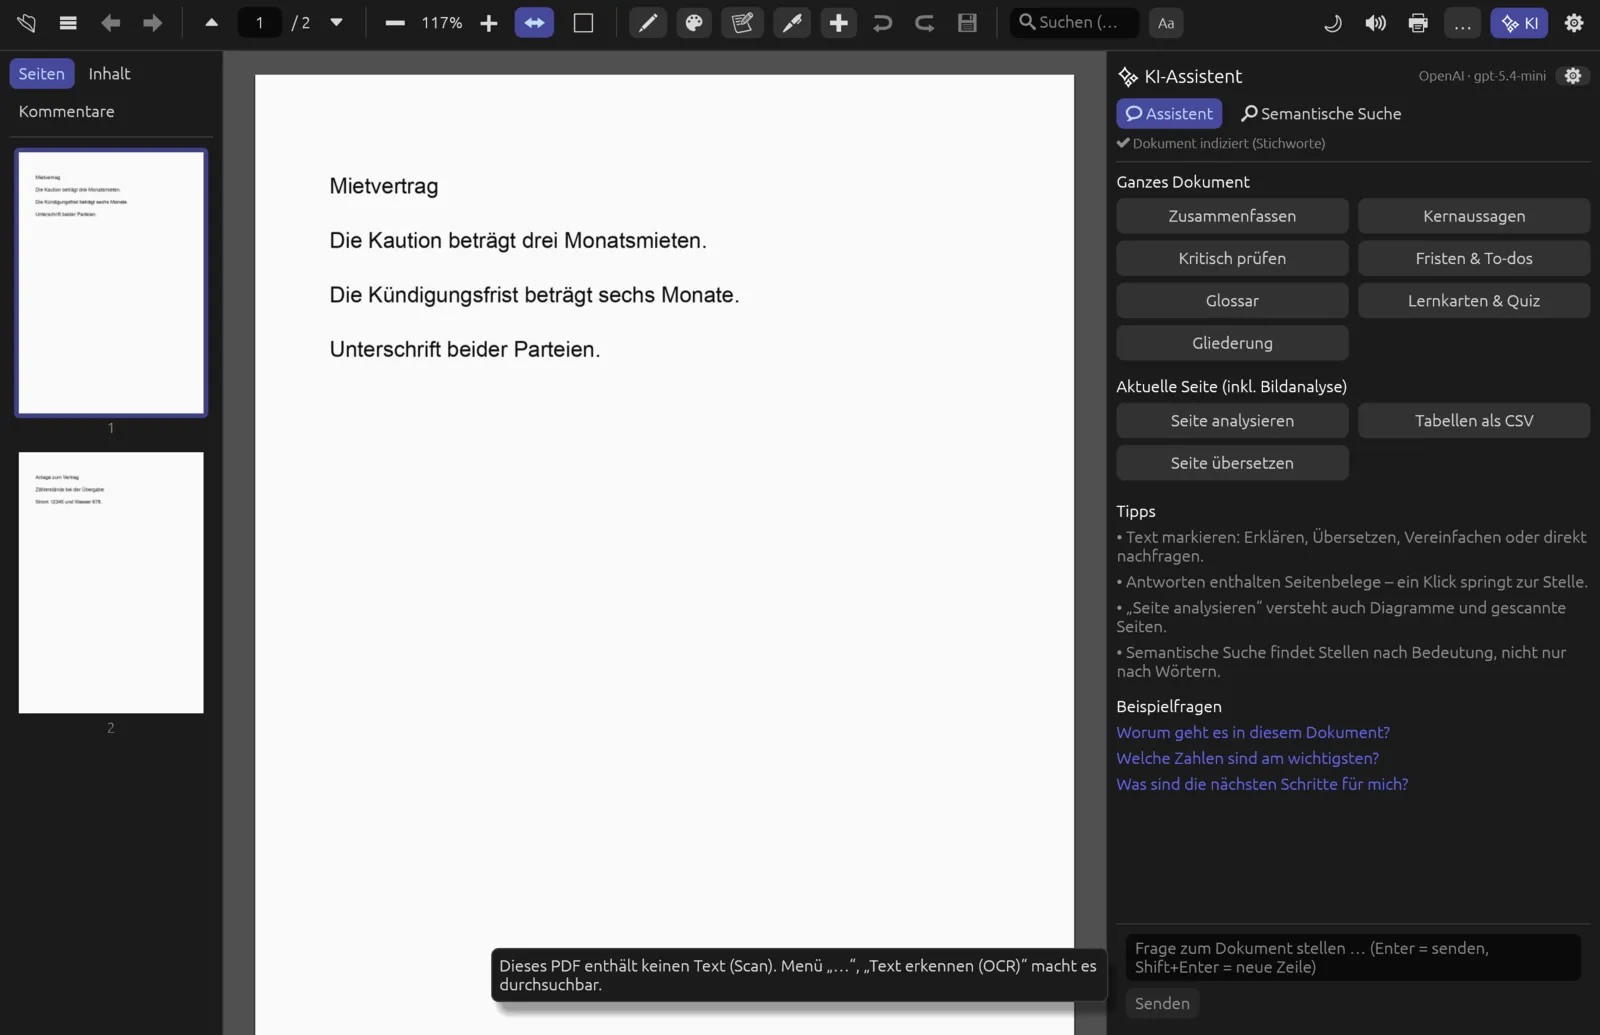
Die Texterkennung nutzt die Dienste deines Betriebssystems, es wird nichts ins Internet geschickt:
| System | Texterkennung |
|---|---|
| macOS | Vision (eingebaut), Sprachen Deutsch, Englisch und Französisch. |
| Windows | Windows-Texterkennung (eingebaut) in den Sprachen deines Benutzerprofils. |
| Linux | Das Programm tesseract, falls installiert (bevorzugt mit den Sprachpaketen Deutsch, Englisch, Französisch). Fehlt es, meldet Pagelier „Keine Texterkennung verfügbar (unter Linux bitte „tesseract“ installieren)“. |
Einen Scan durchsuchbar machen
- Öffne das gescannte PDF und warte, bis der Text gelesen ist (sonst meldet Pagelier „Text wird noch gelesen … gleich erneut versuchen“).
- Wähle . Die Meldung „Texterkennung: 1 von 2 Seiten“ zeigt den Fortschritt.
- Willst du abbrechen, wähle im selben Menü .
- Am Ende meldet Pagelier „Texterkennung fertig: N Seite(n) durchsuchbar“. Jetzt kannst du suchen, markieren und den KI-Assistenten fragen.
- Speichere mit ⌘ S, damit die Textebene in der Datei bleibt.
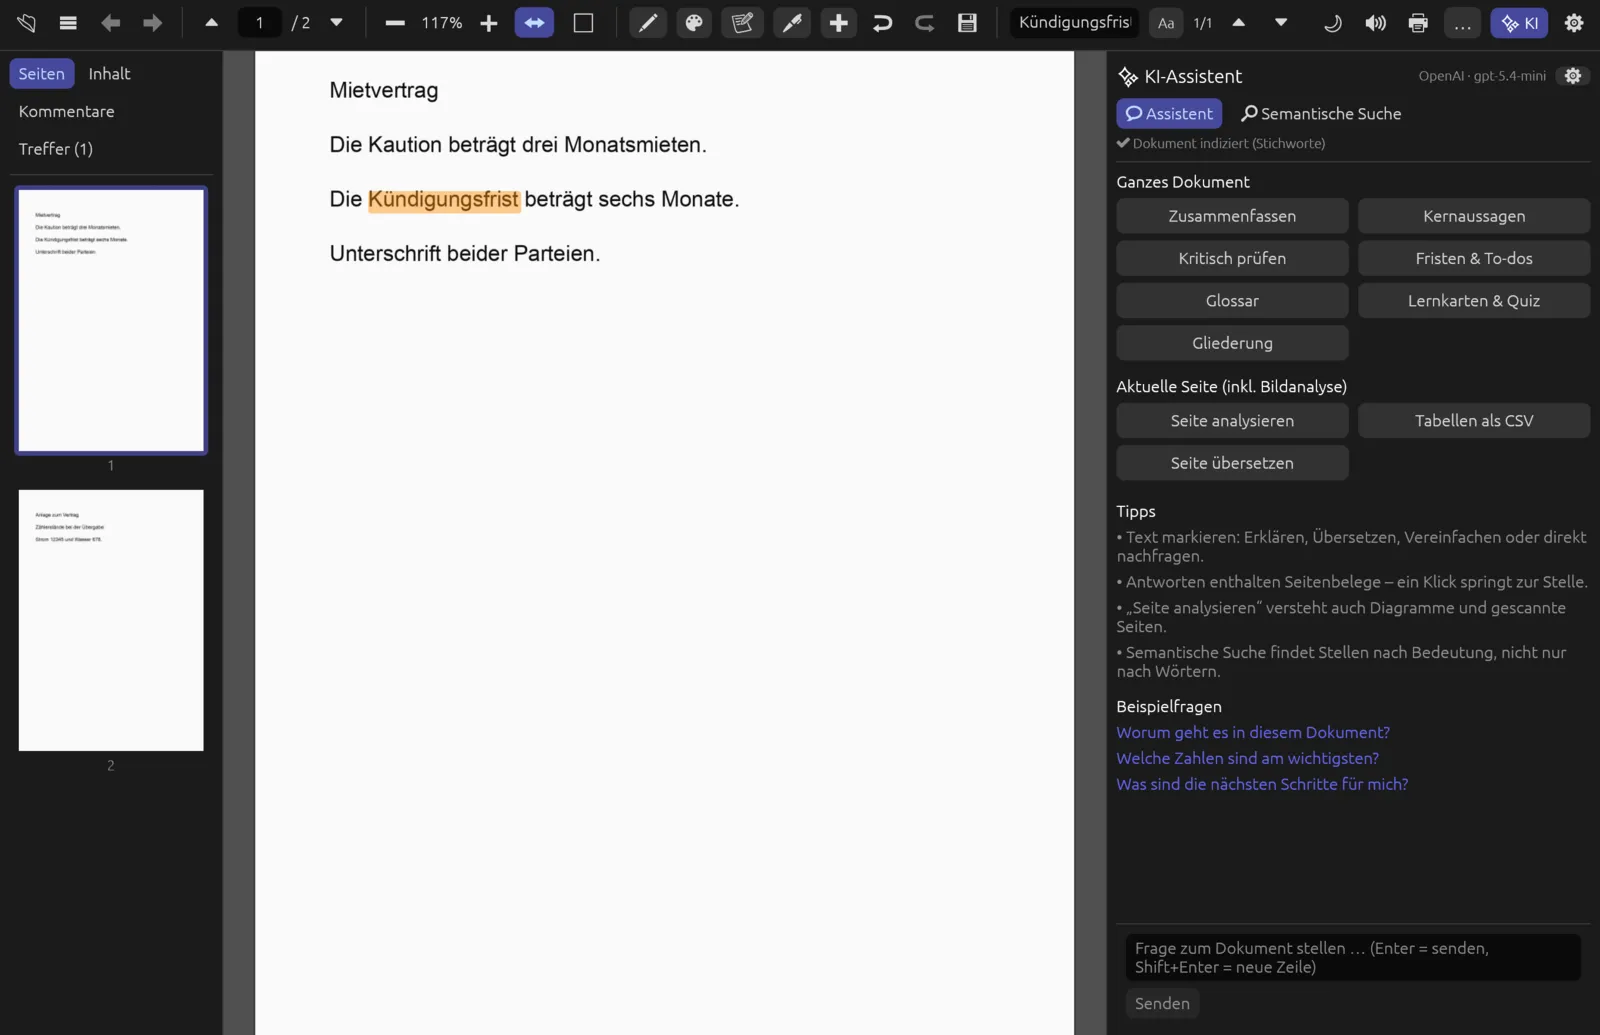
Erkannt werden nur Seiten, die (fast) keinen Text enthalten; Seiten mit echtem Text bleiben unberührt. Sind alle Seiten schon mit Text versehen, meldet Pagelier „Alle Seiten enthalten bereits Text“. Das Aussehen der Seiten ändert sich nicht – der erkannte Text liegt unsichtbar über dem Bild.
Wie gut die Erkennung ist, hängt vom Scan ab: Schiefe, unscharfe oder sehr kleine Schrift führt zu Fehlern, Handschrift wird meist nicht erkannt. Prüfe wichtige Stellen, bevor du dich auf die Suche verlässt.
Aus PDF exportieren
Als Word-Dokument
fragt nach einem Dateinamen und schreibt den Text des Dokuments in eine Word-Datei. Pagelier fügt Zeilen zu Absätzen zusammen, verbindet Silbentrennungen, erkennt Überschriften an der größeren Schrift (zwei Ebenen) und setzt nach jeder PDF-Seite einen Seitenumbruch. Am Ende meldet es „Word-Dokument gespeichert: Name.docx“.
Übernommen wird nur der Text. Bilder, Tabellen, Spalten, Schriftarten und Farben gehen verloren – das Word-Dokument ist ein Ausgangspunkt zum Weiterschreiben, keine Kopie des Layouts. Enthält das PDF keinen Text, kommt „Das Dokument enthält keinen Text – erst „Text erkennen (OCR)“ ausführen“.
Als Bilder
- speichert die aktuelle Seite als PNG mit 300 dpi, vorgeschlagen als „Name-Seite-1.png“.
- fragt nach einem Ordner und speichert jede Seite als PNG mit 150 dpi: „Name-Seite-001.png“, „Name-Seite-002.png“ usw.
Als Text
speichert den Text aller Seiten als UTF-8-Textdatei. Jede Seite beginnt mit einer Zeile wie ===== Seite 1 =====, damit du die Stellen wiederfindest.
Ins PDF umwandeln
Bilder zu PDF
Fotos von Belegen, Whiteboards oder einzelnen Blättern fasst du zu einem PDF zusammen. Jedes Bild wird eine A4-Seite – hochkant oder quer, je nach Bild – und wird mit etwas Rand eingepasst und zentriert. Unterstützt werden PNG und JPEG.
Mehrere Fotos zu einem PDF zusammenfassen
- Wähle .
- Markiere im Dialog alle gewünschten Bilder (mit ⌘-Klick mehrere) und bestätige.
- Gib im zweiten Dialog einen Namen für die PDF ein (vorgeschlagen: „Bilder.pdf“).
- Die neue PDF öffnet sich in einem eigenen Tab. Seiten umsortieren oder drehen kannst du wie gewohnt (siehe Seiten & Dokumente).
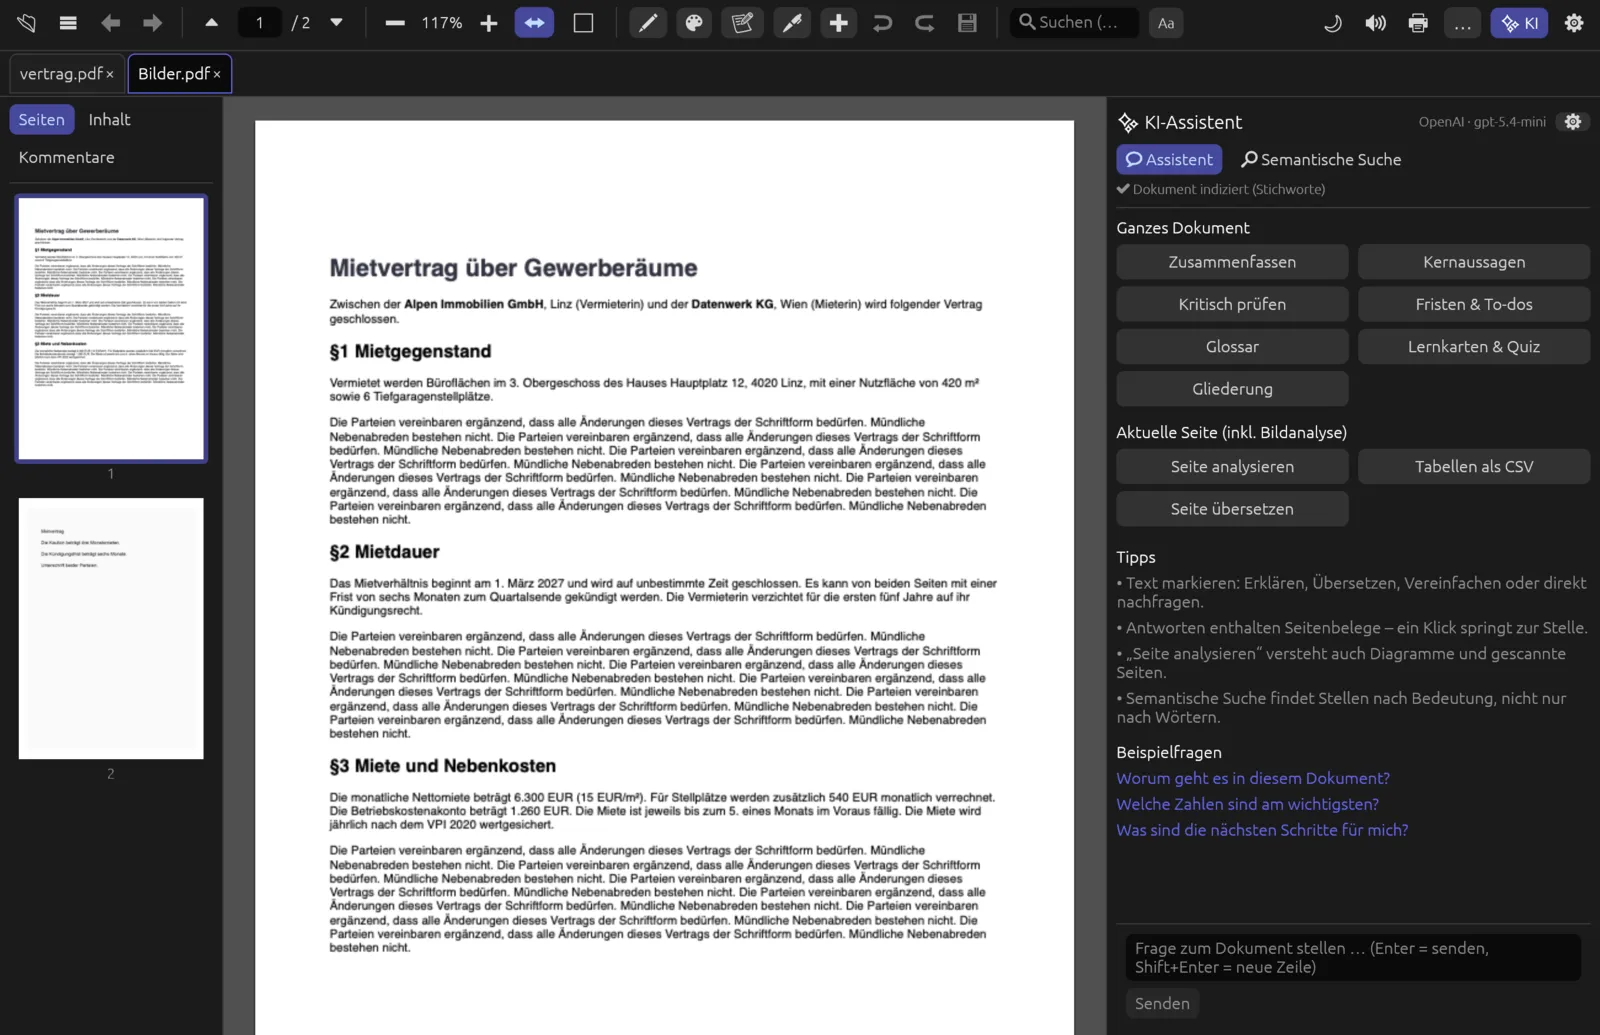
Die Seiten der neuen PDF sind Bilder ohne Text. Mit der Texterkennung machst du sie anschließend durchsuchbar.
Office-Dateien als PDF öffnen
wandelt Dateien in den Formaten .docx, .doc, .odt, .rtf, .txt, .xlsx, .xls, .ods, .csv, .pptx, .ppt und .odp in ein PDF um und öffnet es. Die eigentliche Umwandlung übernimmt LibreOffice im Hintergrund – es muss installiert sein (kostenlos auf libreoffice.org). Pagelier sucht es an den üblichen Orten (unter macOS in /Applications, unter Windows in C:\Program Files, unter Linux in /usr/bin, sonst über den Suchpfad). Ein geöffnetes LibreOffice stört nicht.
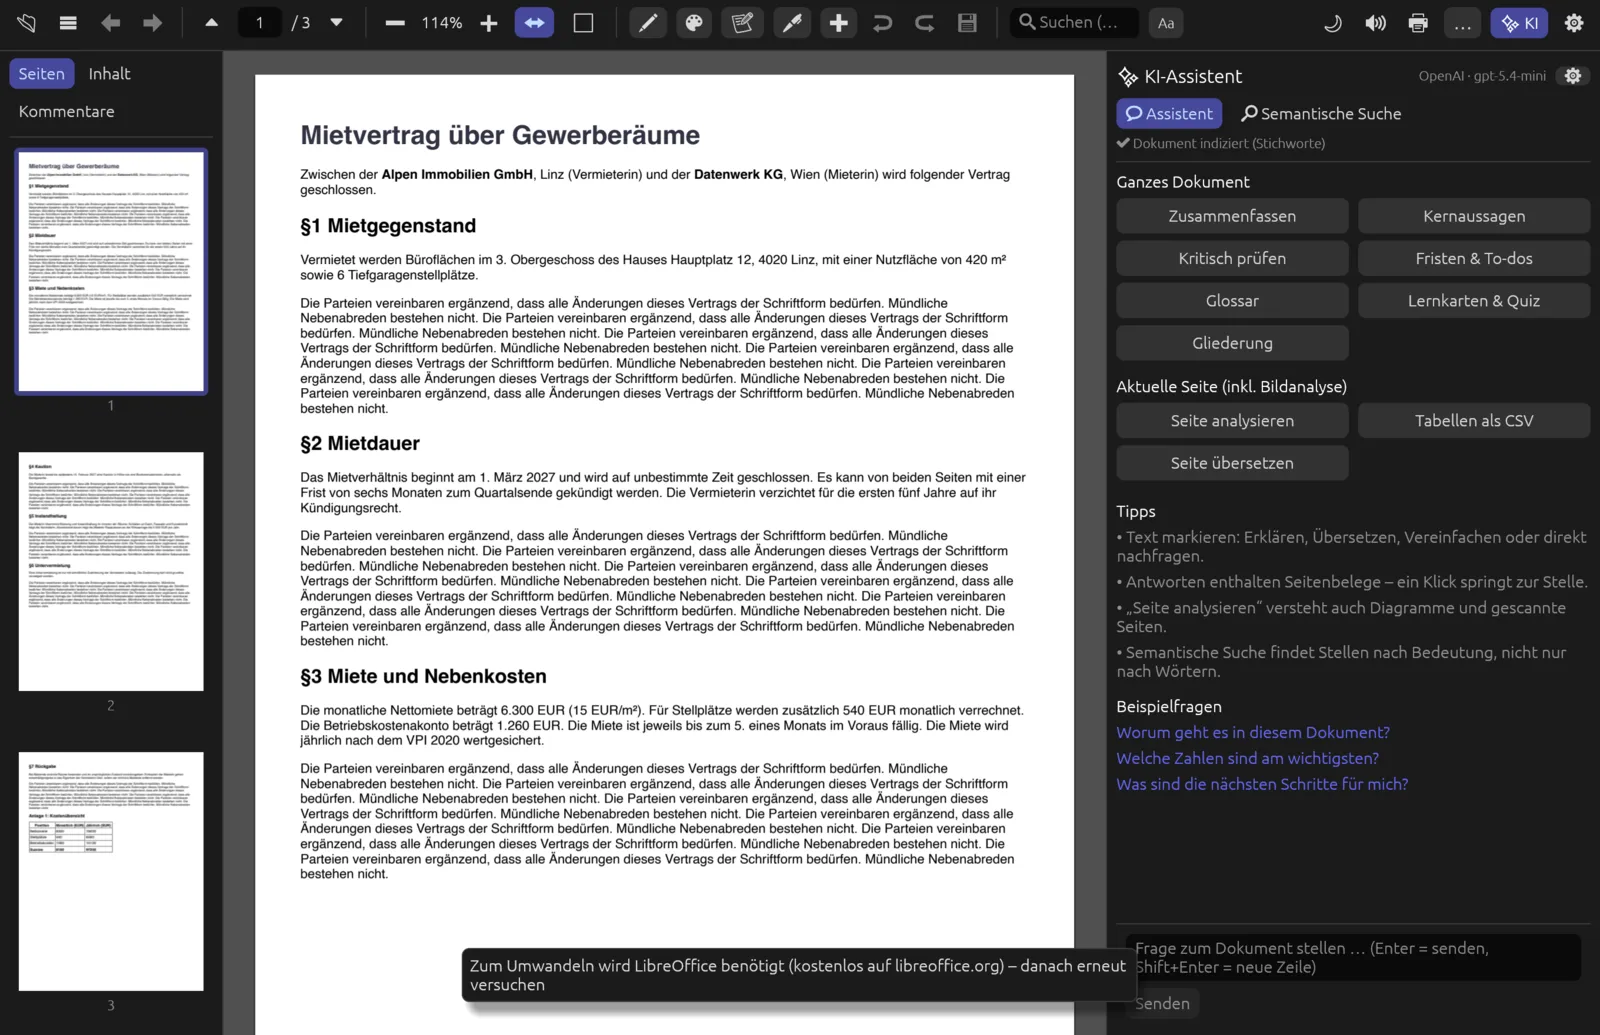
Eine Word-Datei als PDF speichern
- Installiere LibreOffice, falls noch nicht geschehen.
- Wähle und wähle die Datei. Die Meldung „Wandle mit LibreOffice um …“ erscheint.
- Nach einigen Sekunden öffnet sich das PDF in einem neuen Tab.
- Speichere es mit (⌘ ⇧ S) an einem Ort deiner Wahl – das umgewandelte PDF liegt zunächst nur in einem temporären Ordner.
Das Ergebnis hängt von LibreOffice ab: Bei komplexen Word- oder PowerPoint-Dateien können Schriften, Abstände oder Umbrüche etwas vom Original abweichen.